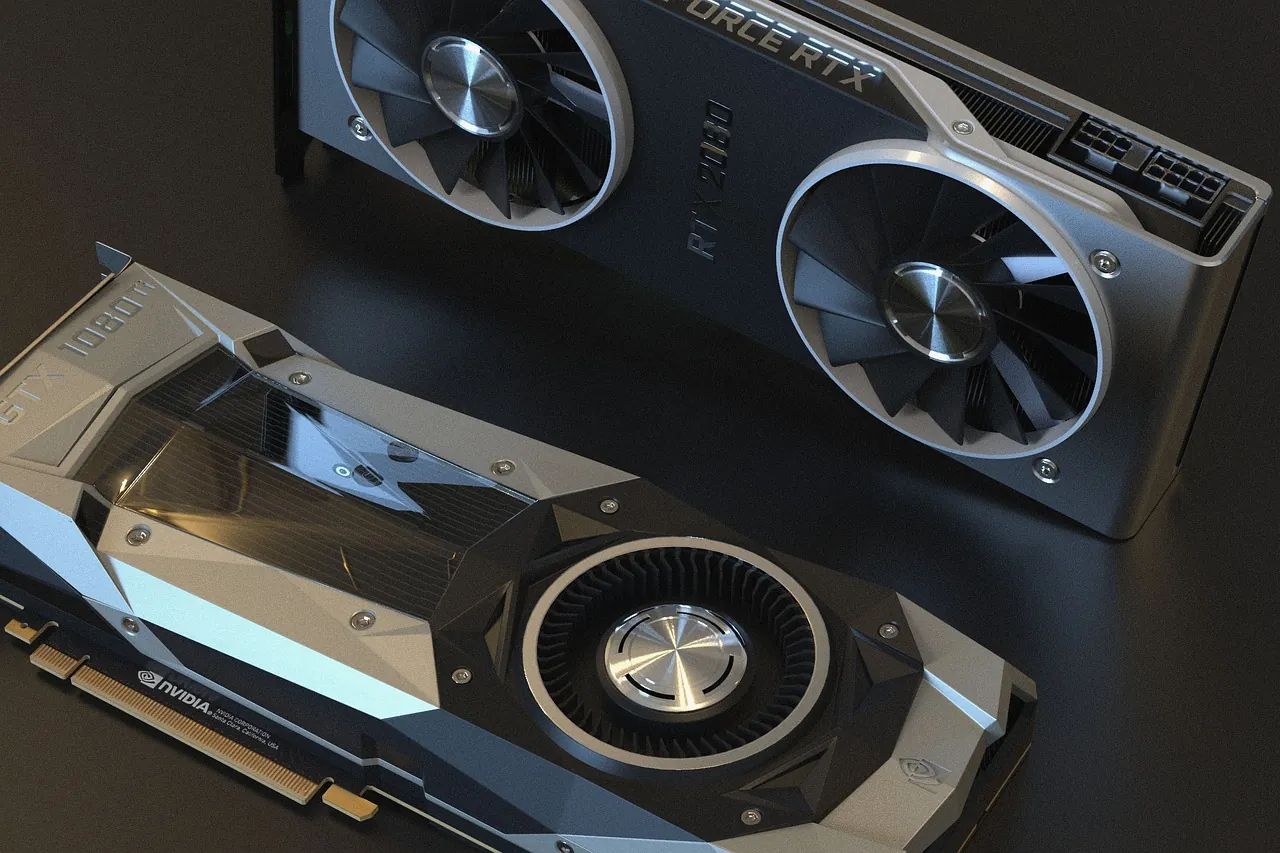
PC per intelligenza artificiale in locale: 4 configurazioni
Quattro macchine per l'AI in locale con i prezzi di novembre 2026, dal PC con RTX 5060 Ti al Mac Studio M5 Max, con il modello da usare su ognuna e il simulatore già compilato.

Scegli il tuo Mac o la tua scheda video, la dimensione del modello e la quantizzazione: vedi quanta memoria serve, se ci sta e quanti token al secondo puoi aspettarti al massimo. Prima di comprare hardware o di scaricare 40 GB di modello.
Cerco tra i modelli GGUF di testo più scaricati su Hugging Face, pubblicati da autori noti (lmstudio-community, ggml-org, unsloth, Qwen), e ti mostro quelli che stanno nella memoria del simulatore, con la quantizzazione e il contesto che hai scelto.
L'elenco si carica da solo quando usi il simulatore (rilevi il computer, scegli la memoria o sposti un cursore), oppure con il pulsante: il tuo browser chiede l'elenco pubblico a huggingface.co, che vede il tuo indirizzo IP come ogni sito che visiti. I numeri del simulatore non vengono inviati. Clicca su un modello per provarlo nel simulatore.
 DeepSeek
 Qwen
 Ollama
 Unsloth
Un modello gira bene solo se pesi e contesto stanno tutti nella memoria più veloce che hai: la VRAM della scheda video o la memoria unificata del Mac. Una volta dentro, la velocità la decide la banda.
| Pesi del modello | miliardi di parametri × bit per peso ÷ 8 (GB) |
|---|---|
| Cache del contesto | migliaia di token × 0,125 GB × √(miliardi di parametri ÷ 8) |
| Buffer di calcolo | 0,5 GB, una stima fissa |
| Memoria che serve | pesi + cache del contesto + buffer |
| Memoria disponibile | memoria per il modello − memoria lasciata al sistema |
| Modello più grande | la dimensione con cui la memoria che serve è uguale a quella disponibile |
| Velocità massima teorica | banda di memoria ÷ pesi del modello: per ogni token il modello legge tutti i pesi |
Ollama e llama.cpp possono spostare una parte del modello nella RAM e farla calcolare al processore. Funziona, ma quella parte va alla velocità della RAM, spesso dieci volte meno della VRAM.
A 4-5 bit per peso un modello occupa circa un terzo della versione a 16 bit e perde poco in qualità. Sotto i 4 bit la qualità cala in modo più evidente, soprattutto nei modelli piccoli.
La velocità massima teorica dice quanto potresti andare se la memoria lavorasse sempre al massimo. Nella pratica si va più piano; serve a confrontare due macchine, non a promettere un numero.
Banda e memoria dei Mac vengono dalle presentazioni di Apple: M4, M4 Pro e M4 Max e M5. Quelle delle schede video dalle specifiche di NVIDIA e dei suoi partner. La memoria lasciata al sistema è una mia scelta prudente: cambiala con i tuoi numeri.
I bit per peso dei formati GGUF vengono dallo strumento di quantizzazione di llama.cpp, misurati su un modello da 8 miliardi di parametri. La cache del contesto parte dall'architettura di Llama 3.1 8B (32 strati, 8 teste per chiavi e valori da 128 dimensioni, cache a 16 bit: 0,125 GB ogni 1.000 token) e cresce con la radice della dimensione del modello, una semplificazione che torna con Qwen2.5 32B e Llama 3.1 70B.
Quale hardware scegliere e come leggere questi numeri lo spiego nell'articolo Ollama requisiti minimi: hardware per un LLM locale. Per installare il primo modello c'è la guida Installare Ollama e un LLM in locale.
Non trovi la tua domanda? Scrivimi i tuoi numeri e il dubbio che hai: ti rispondo io.
Fai una domandaDipende dal modello e dalla quantizzazione. In Q4 un modello da 8 miliardi di parametri chiede circa 6-7 GB con un contesto di 8.000 token, uno da 32 miliardi circa 22 GB, uno da 70 miliardi più di 45 GB.
Una scheda video ha più banda, quindi a parità di modello va più veloce, ma la VRAM è poca e cara. Un Mac con molta memoria unificata fa girare modelli più grandi, più piano. Prova le due configurazioni nel simulatore con il modello che ti serve.
È un formato di quantizzazione di llama.cpp: i pesi del modello vengono salvati con circa 4,9 bit invece di 16. Il file pesa circa un terzo e il modello perde poco in qualità.
Il simulatore mostra il tetto teorico, con la memoria sempre alla massima velocità. Nella realtà contano il software, la lettura del prompt, la temperatura del portatile e le altre app aperte.


Cosa ti porta un budget mensile in Google Ads o Meta Ads, e quanto devi spendere per le vendite che vuoi.
Dai costi veri di un ordine, IVA esclusa, il ROAS sotto cui perdi e quanto puoi pagare una vendita o un clic.
Clic, spesa e conversioni della rete di ricerca, e cosa cambia se l'annuncio compare più spesso.
Scegliamo insieme hardware e modello per i tuoi casi d'uso, con i dati che restano in azienda e senza comprare più di quello che serve.
Quattro macchine per l'AI in locale con i prezzi di novembre 2026, dal PC con RTX 5060 Ti al Mac Studio M5 Max, con il modello da usare su ognuna e il simulatore già compilato.
Quanta memoria serve per far girare un modello con Ollama, perché la banda conta più dei core e come scegliere tra Mac e scheda video. Con il simulatore per provare il tuo…

Raccontami cosa vuoi proteggere, costruire o far crescere. Ti aiuto a capire da dove partire.
Da oltre trent'anni faccio tre cose. Cerco le falle della tua azienda prima che le trovi chi vuole entrare. Imposto il marketing perché i risultati si possano misurare. E aiuto persone e aziende a capire chi sono, prima ancora di decidere cosa vendere.
 Certified Ethical HackerSicurezza informatica dal 1993
Google AdsMeta
 WordPress
 WooCommerce
 Shopify
 TikTok
Così non devo chiederti in chat le stesse cose e la mia prima risposta parla già del tuo caso. Ci vuole meno di un minuto.
Passo 1 di 4
Leggo ogni recensione e, prima di pubblicarla, ti chiedo conferma ai recapiti che ho già dal nostro lavoro insieme. I campi con l'asterisco sono obbligatori.
Questo sito è un progetto indipendente e non è affiliato, autorizzato o sponsorizzato da Google LLC. I marchi Google Ads, Analytics e BigQuery sono di proprietà esclusiva di Google LLC.
I servizi offerti non sono associati, approvati o sponsorizzati da Meta Platforms, Inc. Facebook e Instagram sono marchi registrati di Meta.
Le certificazioni esposte attestano il superamento degli esami tecnici ufficiali ma non configurano un rapporto di dipendenza con i fornitori delle tecnologie.
Ultimo aggiornamento: febbraio 2026 · Disclaimer completo